
Når AI skriver koden, hvem kontrollerer at den fungerer?
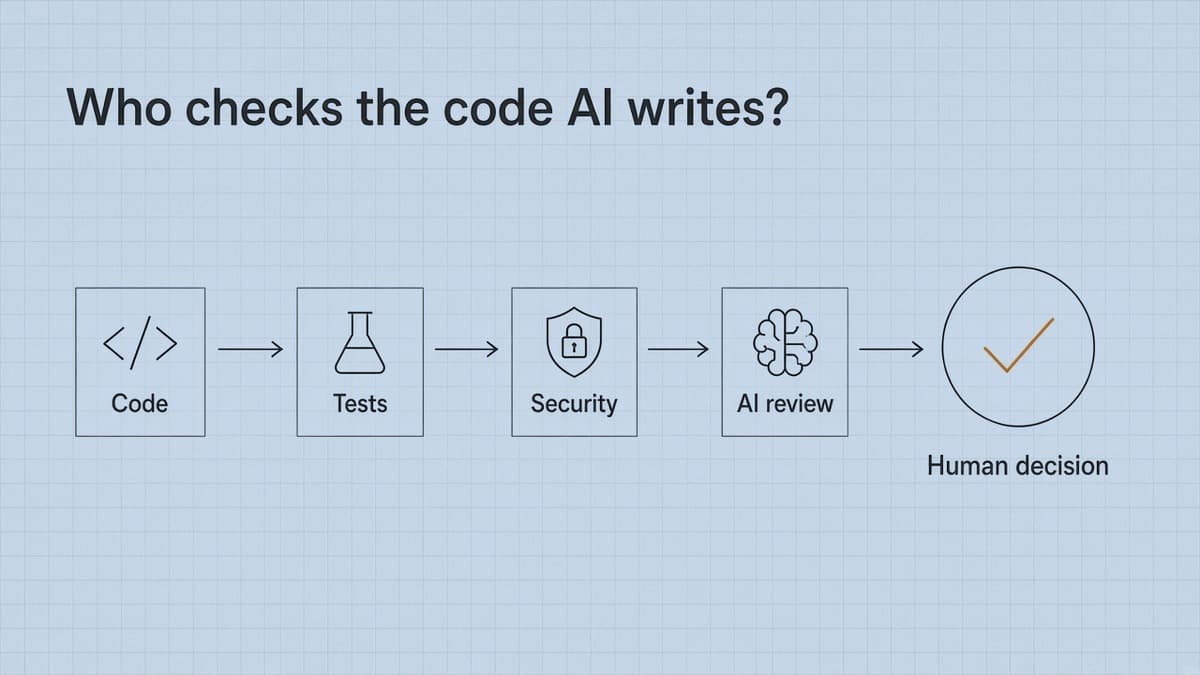
Hos Anthropic skriver kunstig intelligens nå rundt 90 prosent av koden til Claude Code. Det har tvunget selskapet til å tenke nytt om hvordan programvare utvikles og kvalitetssikres. Løsningen er et system der AI-agenter kontrollerer andre AI-agenter, mens mennesker konsentrerer seg om beslutningene som faktisk krever menneskelig vurdering.
Den 15. oktober 2026 publiserte Anthropic en artikkel der Addy Osmani, Morgan Westlee Lunt og Qing Wang fra Claude Code-teamet forklarer hvordan de har endret måten de gjennomgår og kvalitetssikrer kode på.
Bakgrunnen er enkel. AI-agenter som Claude Code, OpenAI Codex og Cursor kan nå skrive, endre og teste programvare på en brøkdel av tiden det tidligere tok en utvikler. Dermed oppstår et nytt problem. Når AI produserer kode raskere enn mennesker klarer å kontrollere den, hvordan sikrer man at resultatet faktisk fungerer?
Anthropic har valgt å automatisere store deler av kontrollen også.
Ifølge selskapet ble antallet kodeendringer som ble tatt inn i Claude Code, mer enn doblet fra juni til september 2026. Samtidig falt andelen endringer som senere måtte rulles tilbake, med over 40 prosent.
Tallene er rapportert av Anthropic selv og viser utviklingen i deres eget team. De dokumenterer ikke alene hvor mye av forbedringen som skyldes den nye kontrollprosessen. Likevel gir selskapets gjennomgang et konkret innblikk i hvordan programvareutvikling er i ferd med å endre seg.
Fra å kontrollere kode til å kontrollere resultater
Tradisjonelt har utvikling av programvare vært organisert rundt mennesker som skriver og kontrollerer kode.
En utvikler skriver en ny funksjon eller retter en feil. Deretter gjennomgår en kollega endringene, ser etter problemer og foreslår forbedringer. Først når kontrollen er gjennomført, blir endringen en del av programmet.
Denne prosessen kalles code review, eller kodegjennomgang.
Når AI-agenter skriver store deler av koden, blir denne arbeidsmetoden vanskeligere å opprettholde. En utvikler kan sette flere agenter til å jobbe samtidig, og hver agent kan produsere betydelige kodeendringer på kort tid.
Antallet endringer kan dermed øke langt raskere enn kapasiteten til menneskene som skal kontrollere dem.
Anthropic mener derfor at man må endre selve spørsmålet man stiller.
Det viktigste er ikke lenger om et menneske har lest hver eneste linje med kode. Det viktigste er hvilke feil som kan oppstå, hvordan de kan oppdages, og hvilke kontroller som egner seg best til å finne dem.
Noen problemer oppdages best gjennom automatiske tester. Andre krever sikkerhetskontroll, mens enkelte beslutninger fortsatt må tas av mennesker.
AI-agenten må bevise at jobben er gjort riktig
En av de viktigste endringene hos Anthropic skjer allerede før kodeendringen sendes videre til gjennomgang.
Når Claude har utført en oppgave, holder det ikke å rapportere at jobben er ferdig. Agenten skal gjennomføre relevante tester og vise resultatene.
Tenk deg at en AI-agent får i oppgave å forbedre bildegalleriet på en nettside.
Den kan skrive ny kode som endrer hvordan bildene vises, men det betyr ikke nødvendigvis at løsningen fungerer. Bildene kan se riktige ut på en stor skjerm, men overlappe hverandre på mobil. En endring kan også påvirke andre deler av nettsiden.
I stedet for å stole på agentens egen vurdering kan systemet kreve at den åpner nettsiden, tester ulike skjermstørrelser og dokumenterer resultatet med skjermbilder og testlogger.
Dette er forskjellen mellom at en AI-agent forteller at noe fungerer, og at den viser dokumentasjon på at det fungerer.
Anthropic lar også en separat AI-agent gjennomgå kodeendringen med det de kaller fresh context, altså uten hele samtalehistorikken fra agenten som skrev koden.
Tanken er at en uavhengig agent lettere kan oppdage problemer som den opprinnelige agenten har oversett.
Flere AI-agenter kontrollerer hverandres funn
Når en kodeendring er klar, opprettes det vanligvis en pull request, ofte forkortet PR.
En PR er et forslag om å legge ny eller endret kode inn i hovedversjonen av et program. Før endringen blir godkjent, kan den gjennomgås og testes uten å påvirke den eksisterende versjonen.
Hos Anthropic blir hver PR kontrollert av AI før et menneske eventuelt ser på den.
Det spesielle er at selskapet ikke bare bruker én kontrollagent. Flere AI-agenter undersøker endringen parallelt for å finne mulige feil. Deretter vurderer en separat gruppe agenter funnene og avgjør hvilke som har tilstrekkelig grunnlag til å rapporteres.
Hvis én agent mener den har funnet et problem, betyr det altså ikke automatisk at koden må endres. Andre agenter undersøker først om problemet faktisk finnes.
Dette er nødvendig fordi AI-agenter også kan ta feil. De kan for eksempel rapportere problemer som ikke finnes.
Slike feilaktige varsler kalles false positives, eller falske alarmer.
Anthropic forsøker derfor å fjerne unødvendige varsler før de når utvikleren. Målet er at menneskene skal bruke tiden sin på reelle problemer i stedet for å undersøke store mengder feilaktige advarsler.
Feil som allerede fantes i koden fra før, er derimot ekte feil. De merkes for seg, slik at de ikke blir lagt på den som gjorde endringen.
Da selskapet introduserte denne typen AI-kodegjennomgang internt, økte andelen PR-er som fikk vesentlige kommentarer, fra 16 til 54 prosent. Det viser at systemet identifiserte flere forhold som fortjente oppmerksomhet, men ikke nødvendigvis at alle kommentarene representerte feil som ville ha rammet brukerne.
Sikkerhet og automatiske tester er egne kontrollnivåer
AI-kodegjennomgangen er bare én del av systemet.
Anthropic har også egne sikkerhetskontroller som undersøker om endringene introduserer sårbarheter. Det kan for eksempel handle om feil i tilgangsstyring, eksponering av sensitive opplysninger eller andre sikkerhetsproblemer.
I tillegg gjennomføres tradisjonelle automatiske tester som kontrollerer at programmet fortsatt fungerer.
Disse testene kan undersøke om koden inneholder tekniske feil, om forskjellige komponenter fungerer sammen, og om endringen har ødelagt eksisterende funksjonalitet.
Det er viktig å skille mellom de forskjellige kontrollene.
En nettside kan fungere helt fint for brukeren, men likevel inneholde et alvorlig sikkerhetshull. Et program kan også være teknisk korrekt og sikkert, men oppføre seg annerledes enn det brukeren forventer.
Derfor er ikke én enkelt test eller én kontrollagent tilstrekkelig.
Hos Anthropic må funn fra både kodegjennomgangen og sikkerhetskontrollen håndteres før en endring kan godkjennes. Problemene må enten rettes eller avsluttes med en begrunnelse dersom de viser seg å være feilaktige.
Hvor mange mennesker må godkjenne endringen?
Anthropic har også endret reglene for menneskelig godkjenning.
Tidligere var det vanlig at en eller flere utviklere måtte godkjenne kodeendringer uavhengig av hvor store eller små de var.
Nå vurderer selskapet endringene etter risiko.
| Risikonivå | Eksempler | Menneskelig godkjenning |
|---|---|---|
| Lav | Dokumentasjon, tekst, funksjoner bare for intern bruk og tillegg som ligger bak en bryter og er slått av for vanlige brukere (feature flag) | Ingen, når automatisk kodegjennomgang og sikkerhetskontroll er bestått |
| Middels | Vanlige produktendringer og følsomme områder som automatisk oppdatering | Én person |
| Høy | Den mest risikable koden og deler som alltid krever to personer | To personer |
En automatisk vurdering bestemmer risikonivået ut fra hva som faktisk er endret. Enkelte spesielt følsomme deler av systemet krever alltid menneskelig kontroll, og de enkleste godkjenningsreglene gjelder bare for betrodde utviklere.
Det betyr at en enkel tekstendring kan gå gjennom hele prosessen uten manuell godkjenning, mens endringer i betaling, innlogging og oppdateringssystemet alltid krever en person.
Det finnes også en tydelig grense. En AI-agents godkjenning teller aldri som en menneskelig godkjenning når systemet krever at et menneske skal ta avgjørelsen.
På denne måten forsøker Anthropic å bruke menneskelig tid der risikoen er størst, i stedet for å behandle alle kodeendringer likt.
Da AI-agentene begynte å kontrollere hverandre i en endeløs løkke
En av de mest interessante erfaringene Anthropic beskriver, er hva som skjedde da de lot AI-agenter gjennomgå og rette kode gjentatte ganger.
I ett tilfelle gikk en kodeendring gjennom mer enn 50 runder med kontroll og rettelser i løpet av én natt før den som sto bak endringen stoppet den.
En kontrollagent fant et problem. Kodeagenten gjorde en endring. Kontrollagenten undersøkte koden på nytt og fant enda et problem. Dermed fortsatte prosessen.
Da ingeniørene undersøkte hva som hadde skjedd, oppdaget de at omtrent 59 prosent av koden som stadig ble påpekt, allerede hadde vært til stede under den første kontrollrunden.
Kontrollagenten fant altså sjelden nye feil. Den fant noen flere av de gamle feilene for hver runde.
Dette illustrerer en utfordring ved selvstendige AI-systemer. Agentene kan fortsette å utføre oppgaver og bruke ressurser uten å komme nærmere et ferdig resultat.
Anthropic innførte derfor tydeligere stoppregler.
Etter tre kontrollrunder ber kontrollagenten den som skrev koden, om å ta et steg tilbake og revurdere fremgangsmåten. Senere gjennomganger begrenses i større grad til nye endringer, og systemet skal ikke rapportere de samme problemene om igjen.
Det viser at mer automatisering ikke nødvendigvis betyr bedre resultater. Agentene trenger klare mål, avgrensninger og regler for når en oppgave skal stoppes eller vurderes på nytt.
Selv godkjent kode kan inneholde feil
Ingen kontrollsystemer er feilfrie, heller ikke når flere AI-agenter gjennomgår hverandres kode.
Derfor har Anthropic lagt stor vekt på å kunne oppdage problemer raskt og rulle tilbake endringene som skaper dem.
Før en endring blir en del av hovedversjonen, gjennomfører systemet også tester som kontrollerer at den fungerer sammen med andre nye endringer.
Det er viktig fordi to kodeendringer kan fungere hver for seg, men skape problemer når de kombineres.
Selskapet bruker dessuten såkalte feature flags. Det er en bryter inne i programmet. Den nye funksjonen er ferdig og ligger i koden, men ingen ser den før noen slår bryteren på. Gjør den skade, kan den slås av igjen med én gang, uten at teamet må lage en ny versjon av programmet.
Nye funksjoner blir ofte først tilgjengelige for ansatte, før de gradvis rulles ut til flere brukere.
Hvis noe likevel går galt, skal det være enkelt å gå tilbake til en tidligere fungerende versjon. Dette kalles rollback.
Tanken er ikke å eliminere enhver mulighet for feil, noe som neppe er realistisk. Målet er å redusere sannsynligheten for feil, oppdage dem tidlig og begrense konsekvensene når de oppstår.
Feilene brukes også til å forbedre kontrollagentene
Anthropic bruker tidligere problemer som grunnlag for å forbedre selve AI-kontrollen.
Når en kodeendring fører til en feil, kan selskapet ta vare på informasjon om hva som gikk galt, hvorfor kontrollsystemet ikke oppdaget problemet, og hvordan feilen ble rettet.
Disse eksemplene inngår deretter i et testgrunnlag som brukes til å vurdere kontrollagentene.
I AI-utvikling kalles slike systematiske tester ofte evaluations, eller evals.
Hvis en kontrollagent oppdateres med nye instrukser, verktøy eller en ny AI-modell, kan den testes mot tidligere kjente feil. Dermed kan utviklerne undersøke om den nye versjonen faktisk oppdager flere reelle problemer, eller bare produserer flere varsler.
Det er en viktig forskjell.
Et system som rapporterer mange mulige feil, er ikke nødvendigvis bedre enn et system som rapporterer færre. Det avgjørende er hvor godt det klarer å finne faktiske problemer uten å skape unødvendig ekstrajobb.
Hva skal menneskene gjøre når AI tar over så mye av kontrollen?
Anthropic understreker at menneskene fortsatt har en sentral rolle. Men rollen endrer seg.
Når AI både kan skrive og kontrollere store mengder kode, blir det mindre hensiktsmessig å bruke menneskelig kapasitet på å gjennomgå alle detaljer.
I stedet konsentrerer ingeniørene seg om å vurdere hvilke funksjoner som bør utvikles, gjennomgå risikabel kode og arkitektur som andre vil kopiere, og ta ansvar for resultatet.
De må også forstå hva testene faktisk dokumenterer, og hva de ikke har undersøkt.
Et annet interessant poeng er hvordan utviklerne holder oversikt over stadig større kodebaser.
Anthropic skriver at ingen på teamet har full oversikt over hele Claude Code i hodet, og at ingen trenger det. Når en ingeniør trenger å forstå en bestemt del av systemet, kan Claude undersøke den aktuelle koden og forklare hvordan den fungerer.
Noen bruker også AI til å bygge små visualiseringer som viser og forklarer hvordan en bestemt del av koden fungerer.
På denne måten brukes AI ikke bare til å skrive kode, men også til å hjelpe utviklerne med å forstå programvaren de har ansvar for.
Det er likevel en vesentlig forskjell mellom å få en forklaring fra AI og å ha verifisert at forklaringen er korrekt. Menneskene må fortsatt kunne vurdere dokumentasjon, oppdage svakheter og ta ansvar for konsekvensene av endringene.
En ny måte å organisere programvareutvikling på
Det Anthropic beskriver, er mer enn en ny metode for å kontrollere kode.
Det viser hvordan utvikling av programvare kan organiseres når AI-agenter tar over stadig flere av de praktiske oppgavene.
En agent kan få ansvaret for å utvikle en funksjon. Andre agenter kan gjennomgå resultatet, finne feil og undersøke sikkerheten. Automatiske tester kan kontrollere at programmet fungerer, mens et overordnet system avgjør hvilke oppgaver som må tilbake til agentene og hvilke som krever menneskelig godkjenning.
Mennesket går dermed fra å være den som nødvendigvis utfører alle oppgavene, til i større grad å definere målene, bestemme kontrollreglene, vurdere risikoen og ta ansvar for resultatet.
Dette er ikke begrenset til Anthropic eller Claude Code. De samme prinsippene kan brukes i utviklingsprosesser med andre AI-kodeagenter, forutsatt at nødvendige verktøy, tester og sikkerhetsmekanismer er på plass.
Det betyr heller ikke at alle bør automatisere hele prosessen. Flere agenter gir mer koordinering, større ressursbruk og nye muligheter for feil. Hvor mye som bør automatiseres, avhenger av prosjektets størrelse, kompleksitet og risiko.
Det interessante ved Anthropics tilnærming er derfor ikke bare at AI skriver rundt 90 prosent av koden til Claude Code.
Det er at selskapet har begynt å organisere kvalitetssikringen rundt den samme teknologien.
Når AI-agenter kan produsere store mengder kode, blir evnen til å kontrollere, dokumentere og ta ansvar for resultatene minst like viktig som evnen til å skrive koden.
Det kan bli en av de viktigste endringene i hvordan programvare utvikles i årene fremover.
Det viktigste å ta med seg
- Hos Anthropic skriver AI rundt 90 prosent av koden til Claude Code, og AI-agenter kontrollerer også store deler av koden før et menneske eventuelt ser på den.
- AI-agenten som skrev koden, må vise testresultater, og flere kontrollagenter vurderer hverandres funn før de rapporteres.
- Hvor mange mennesker som må godkjenne en endring, avhenger av risikoen, og en AI-agents godkjenning teller aldri som en menneskelig godkjenning.
- Agentene trenger klare stoppregler, og tester, brytere som kan slå av en ny funksjon (feature flags) og muligheten til å rulle tilbake endringer begrenser konsekvensene når feil slipper gjennom.
- Menneskene vurderer hvilke funksjoner som bør utvikles, gjennomgår risikabel kode og tar ansvar for resultatet.
- Tallene er Anthropics egne og viser ikke alene hvor mye av forbedringen som skyldes den nye kontrollprosessen.
Kilder og videre lesning
- How the Claude Code team does code review, Addy Osmani, Morgan Westlee Lunt og Qing Wang, Anthropic, 15. oktober 2026.
Artikkelen bygger på Anthropics egen beskrivelse av selskapets utviklingsprosess. De oppgitte resultatene er interne målinger og ikke uavhengig verifiserte sammenligninger med andre utviklingsmetoder.